Conceito
O que significa “calibrar” um LLM?
Nesta página, usamos “calibração” em sentido prático: ajustar configurações e contexto para que o modelo responda de forma mais adequada a um objetivo. Não é o mesmo que treinar o modelo do zero.
Em modelos generativos, a resposta nasce de escolhas probabilísticas de tokens. Parâmetros como temperature, topP e topK influenciam o quanto o modelo explora alternativas. Outros parâmetros, como maxOutputTokens e stopSequences, controlam tamanho e encerramento da resposta.
A calibração também envolve instruções de sistema, exemplos, documentos recuperados por RAG, critérios de qualidade e testes. O objetivo é diminuir o “depende” e tornar o uso da IA mais previsível no trabalho real.
Mapa mental
O que você pode ajustar?
Pense em três camadas: comportamento, amostragem e conhecimento. Cada uma resolve um tipo de problema.
Comportamento
Instruções de sistema, papel, tom, regras, formato esperado e limites do que o modelo deve evitar.
Amostragem
Temperatura, top-p e top-k influenciam a variedade das respostas e o grau de imprevisibilidade.
Tamanho e parada
Max tokens e stop sequences controlam extensão, corte e estrutura final da saída.
Conhecimento
RAG, exemplos, documentos, bases internas e fine-tuning reduzem respostas genéricas e desatualizadas.
Parâmetros principais
Como cada ajuste muda a resposta.
Os nomes e limites variam entre provedores e modelos. Sempre confira a documentação da ferramenta usada.
Ambiente dos exemplos
Abrir AI Studio ↗
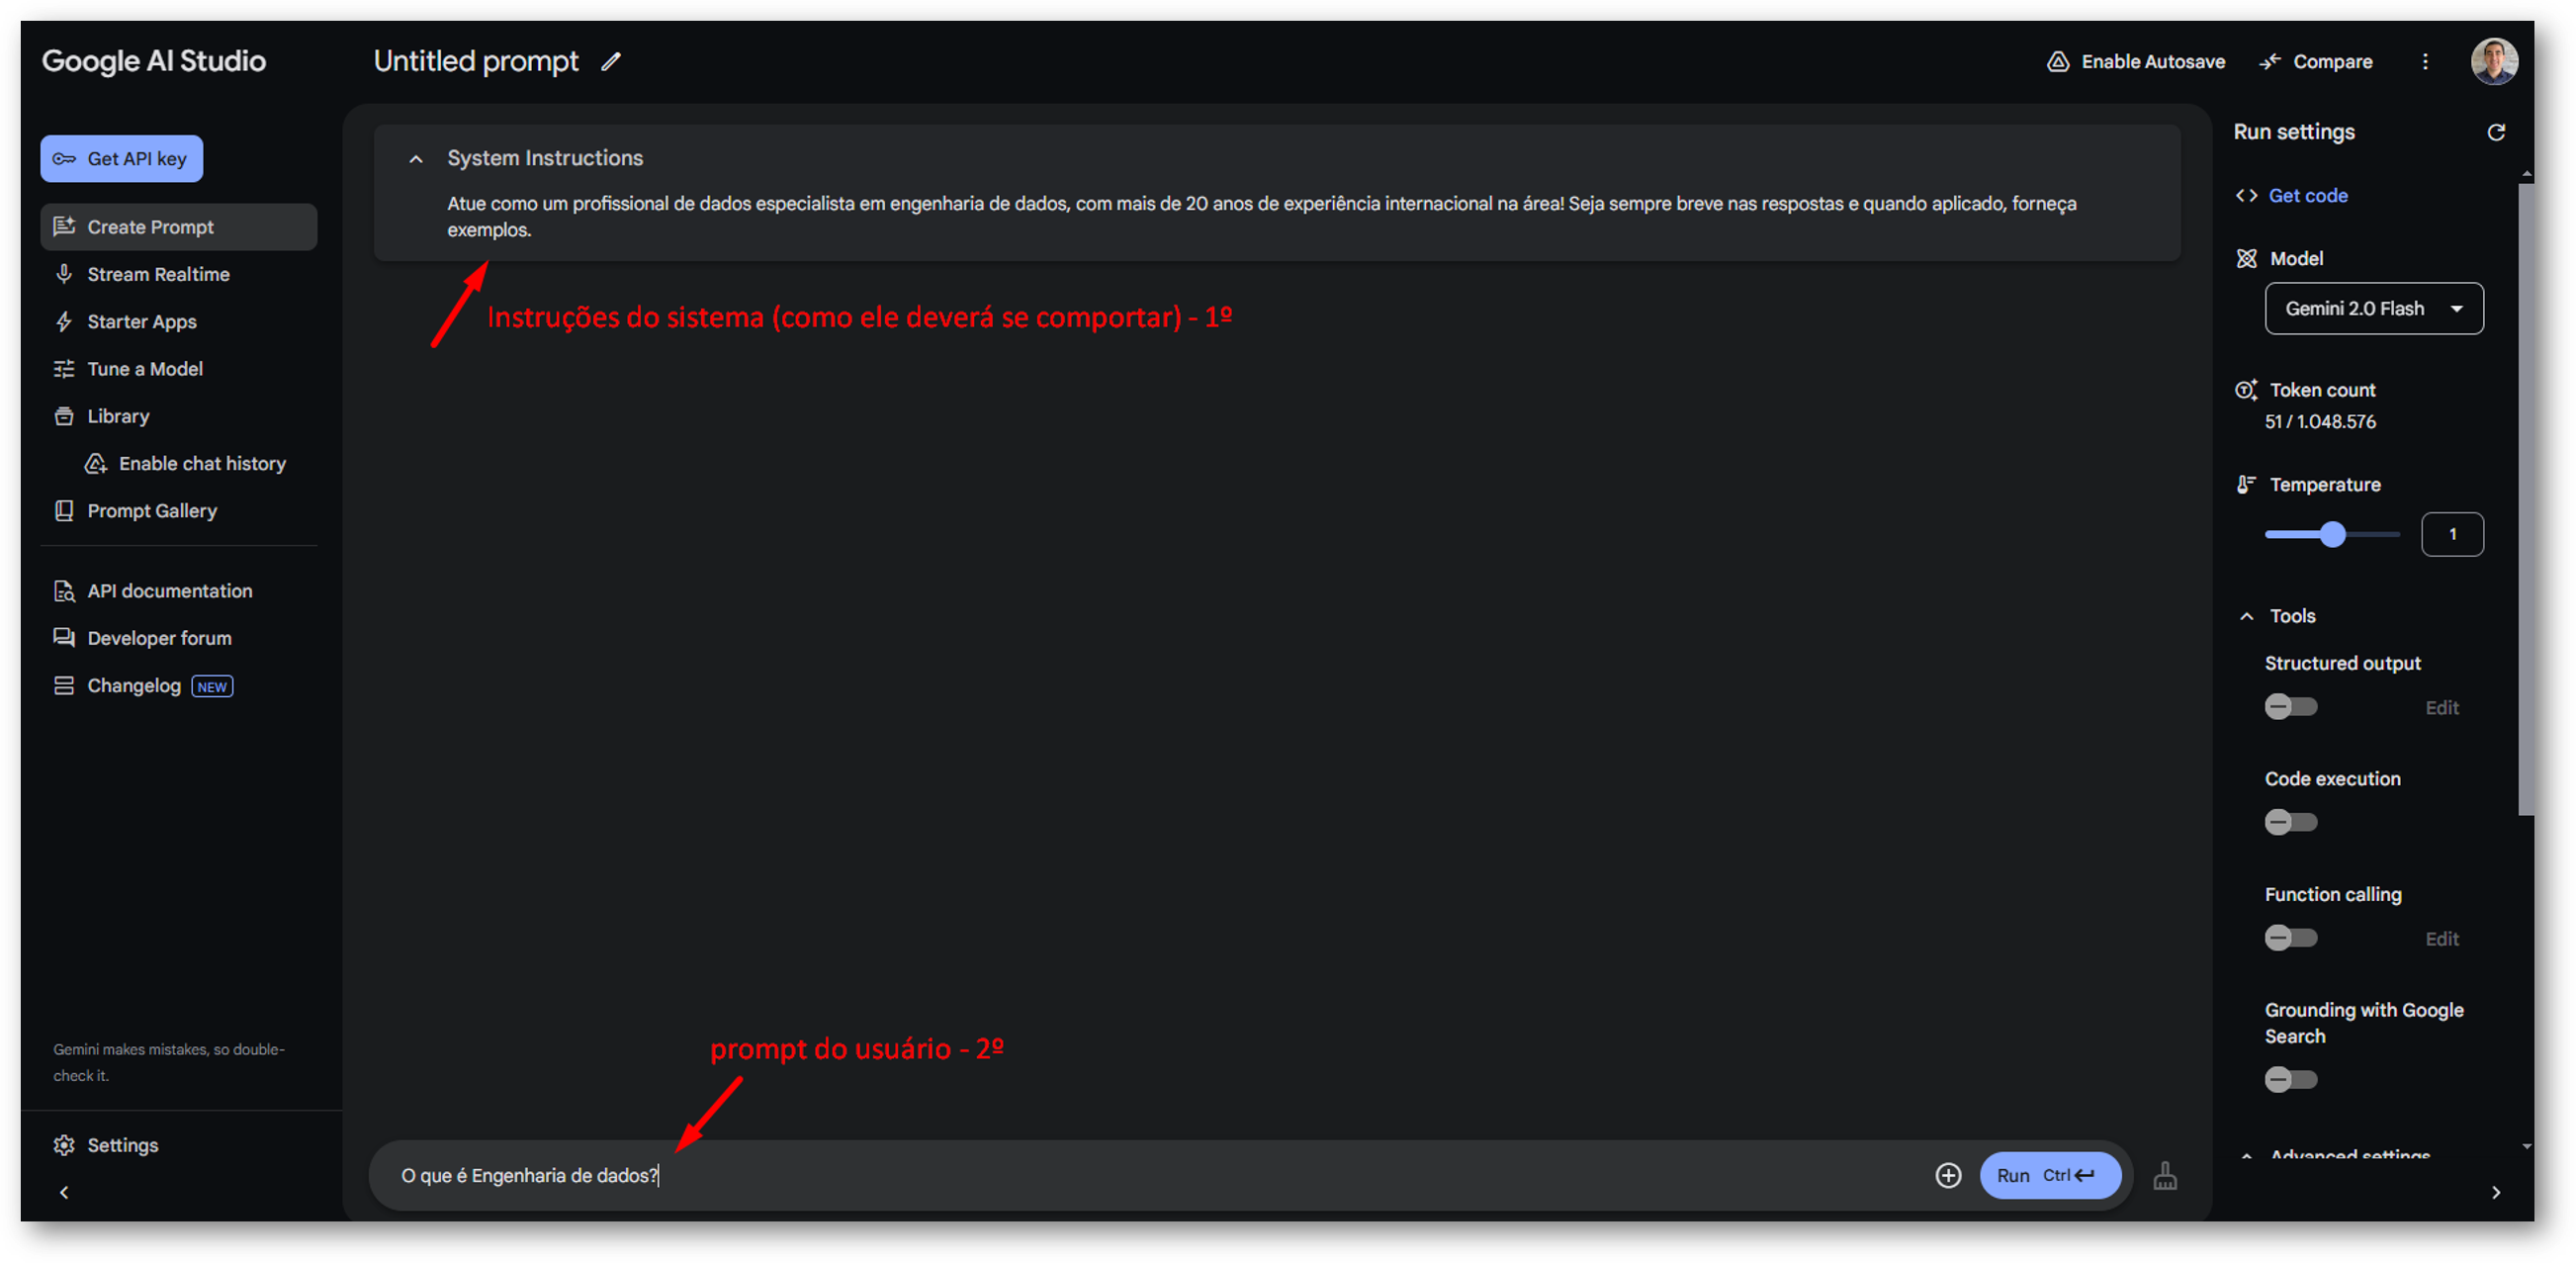
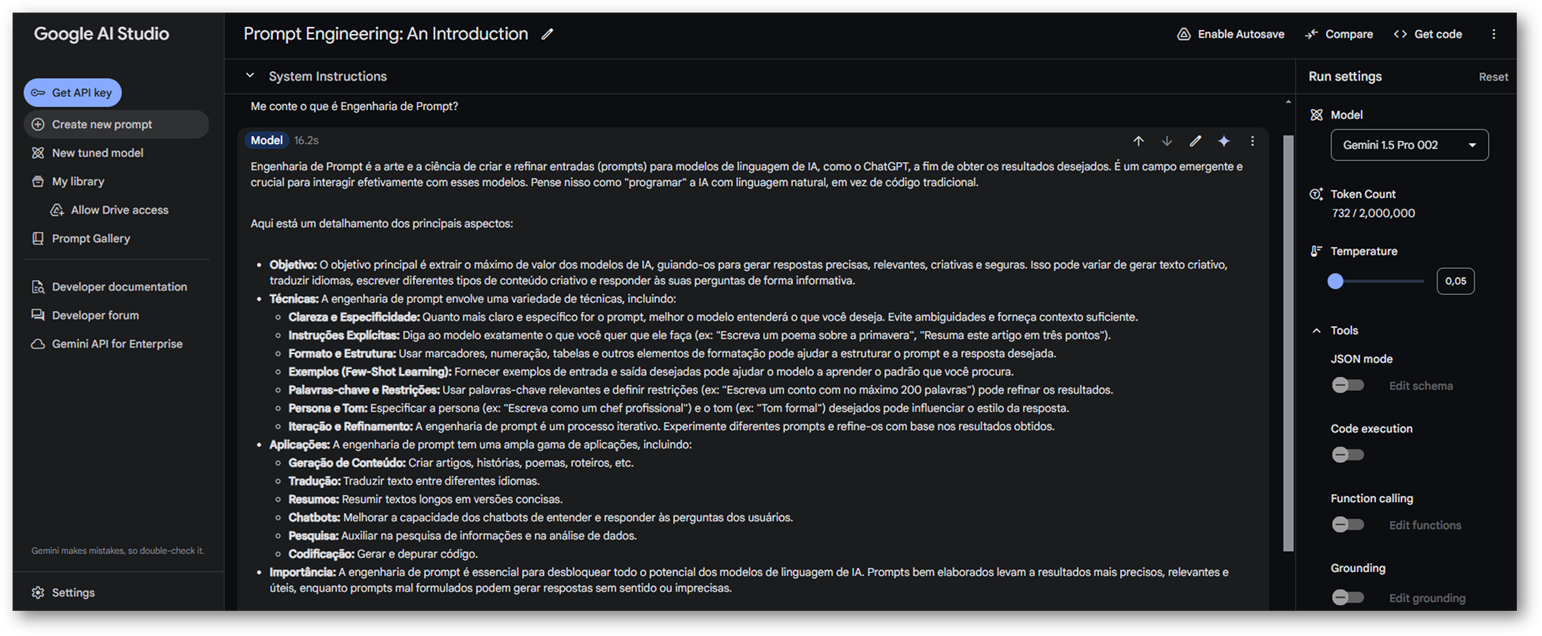
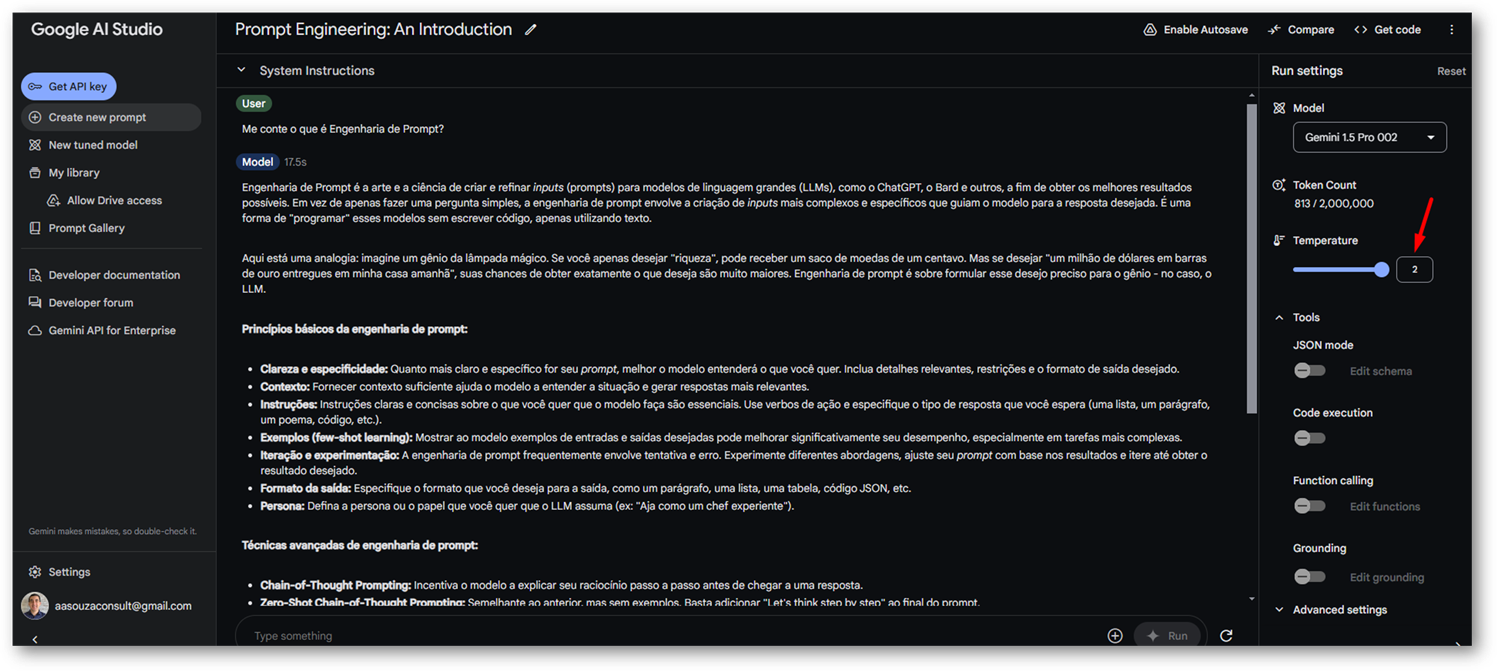
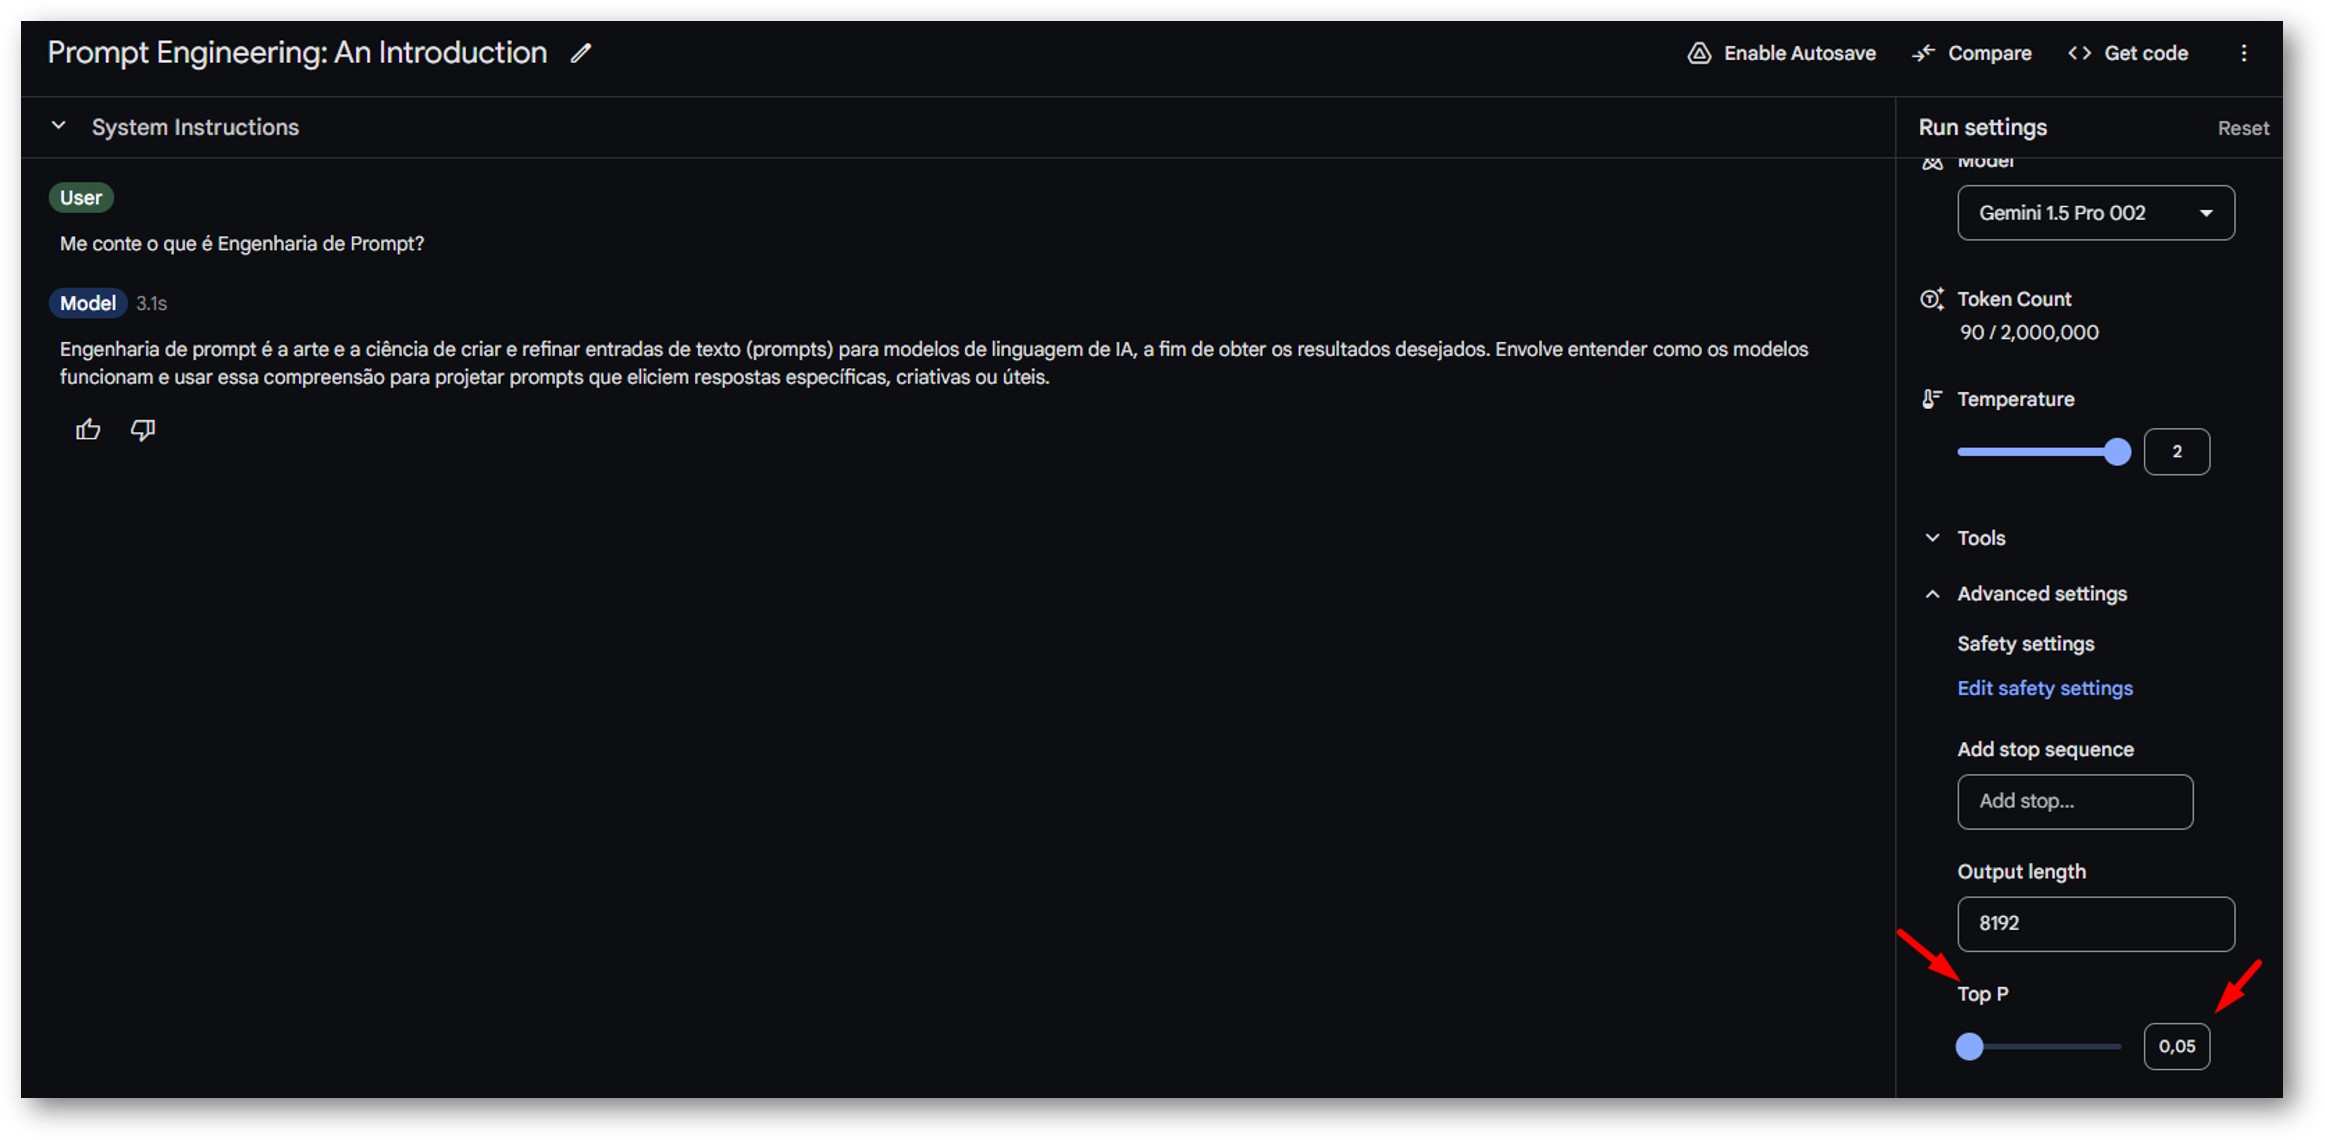
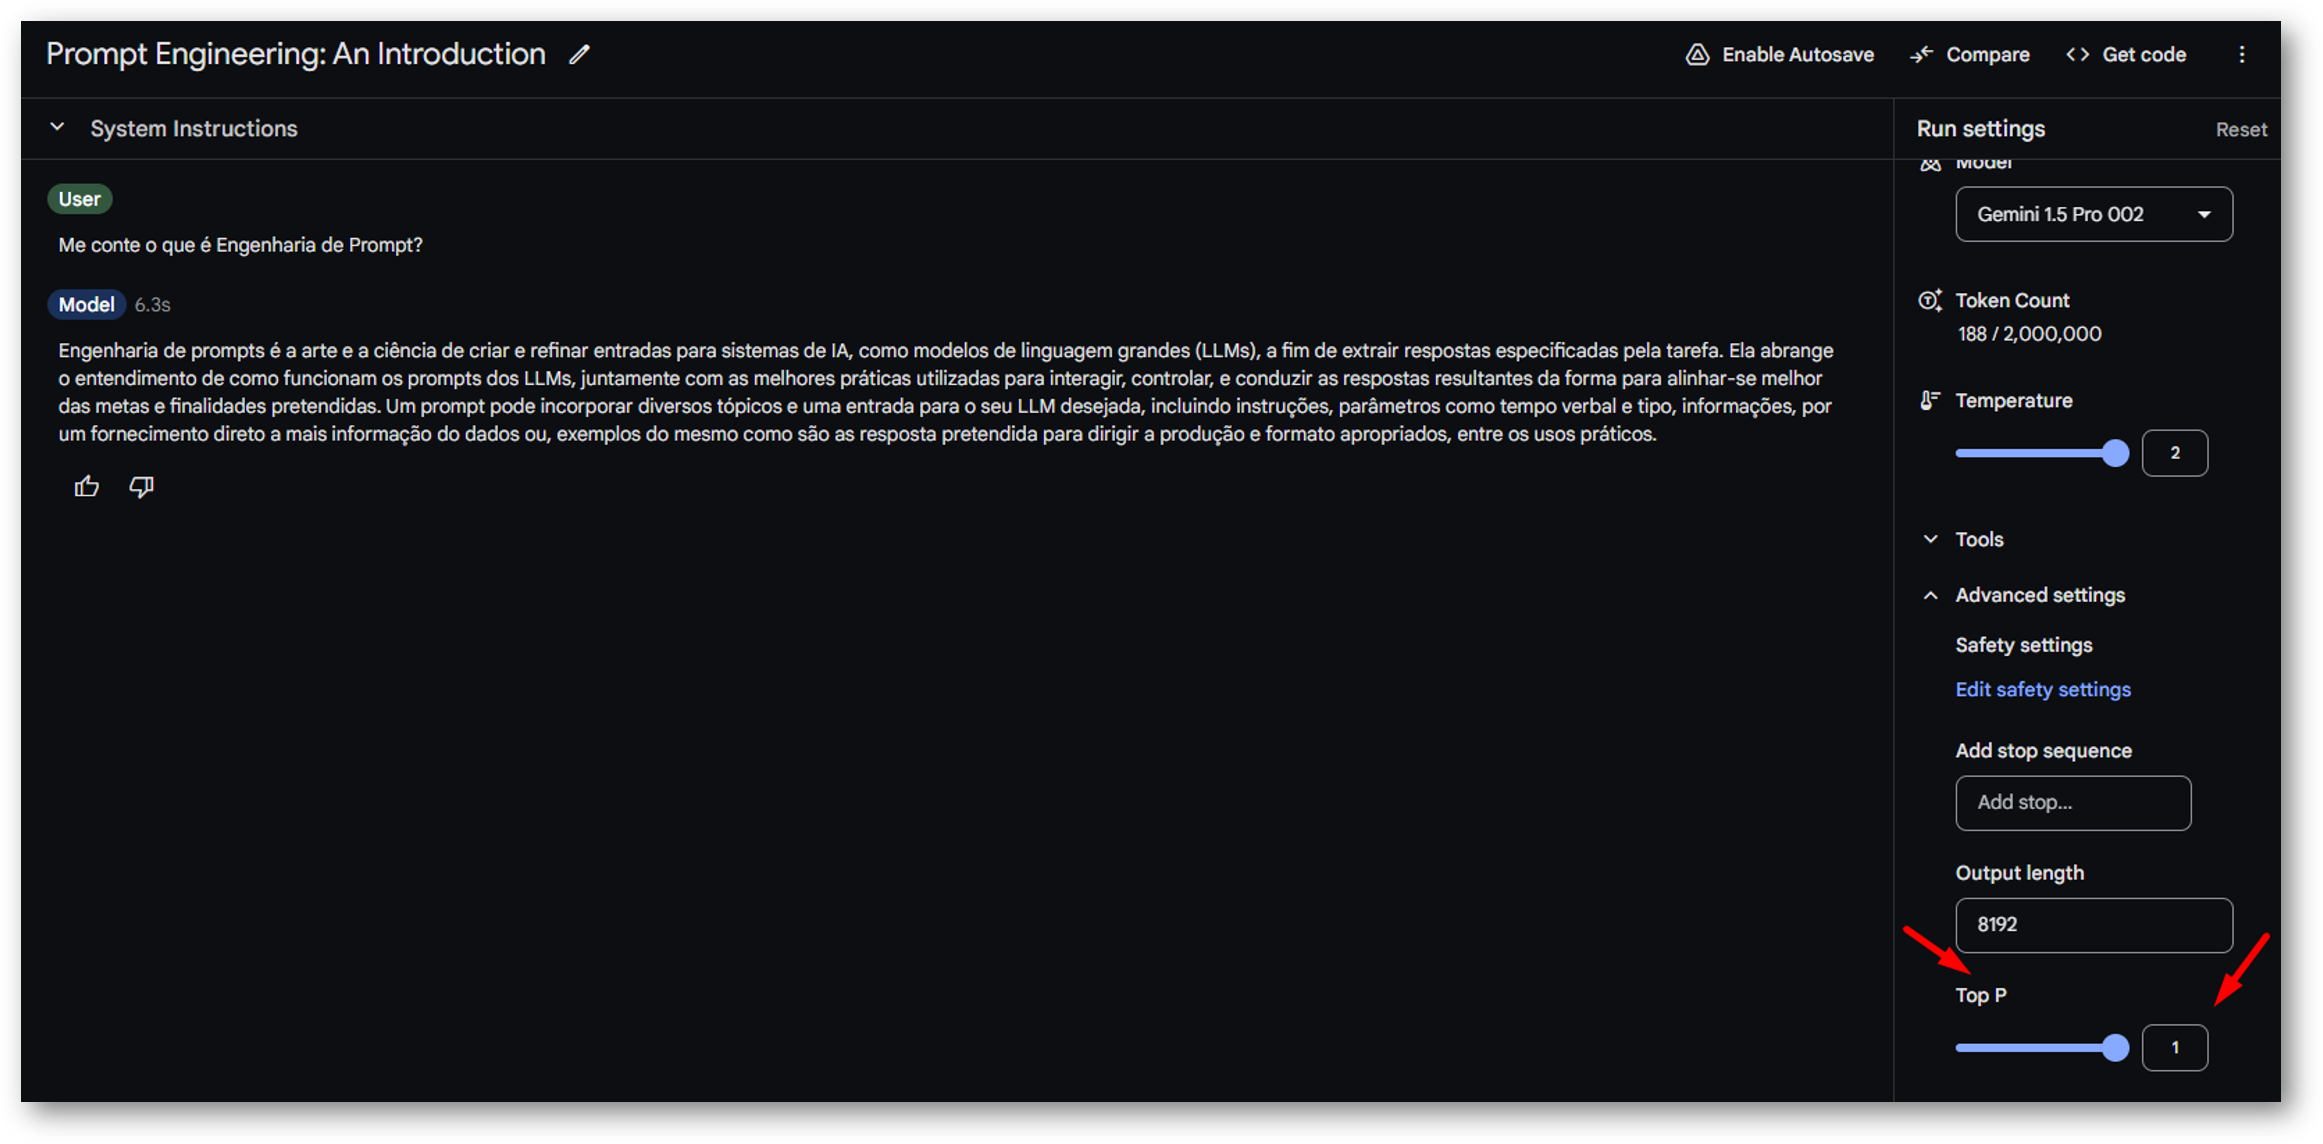
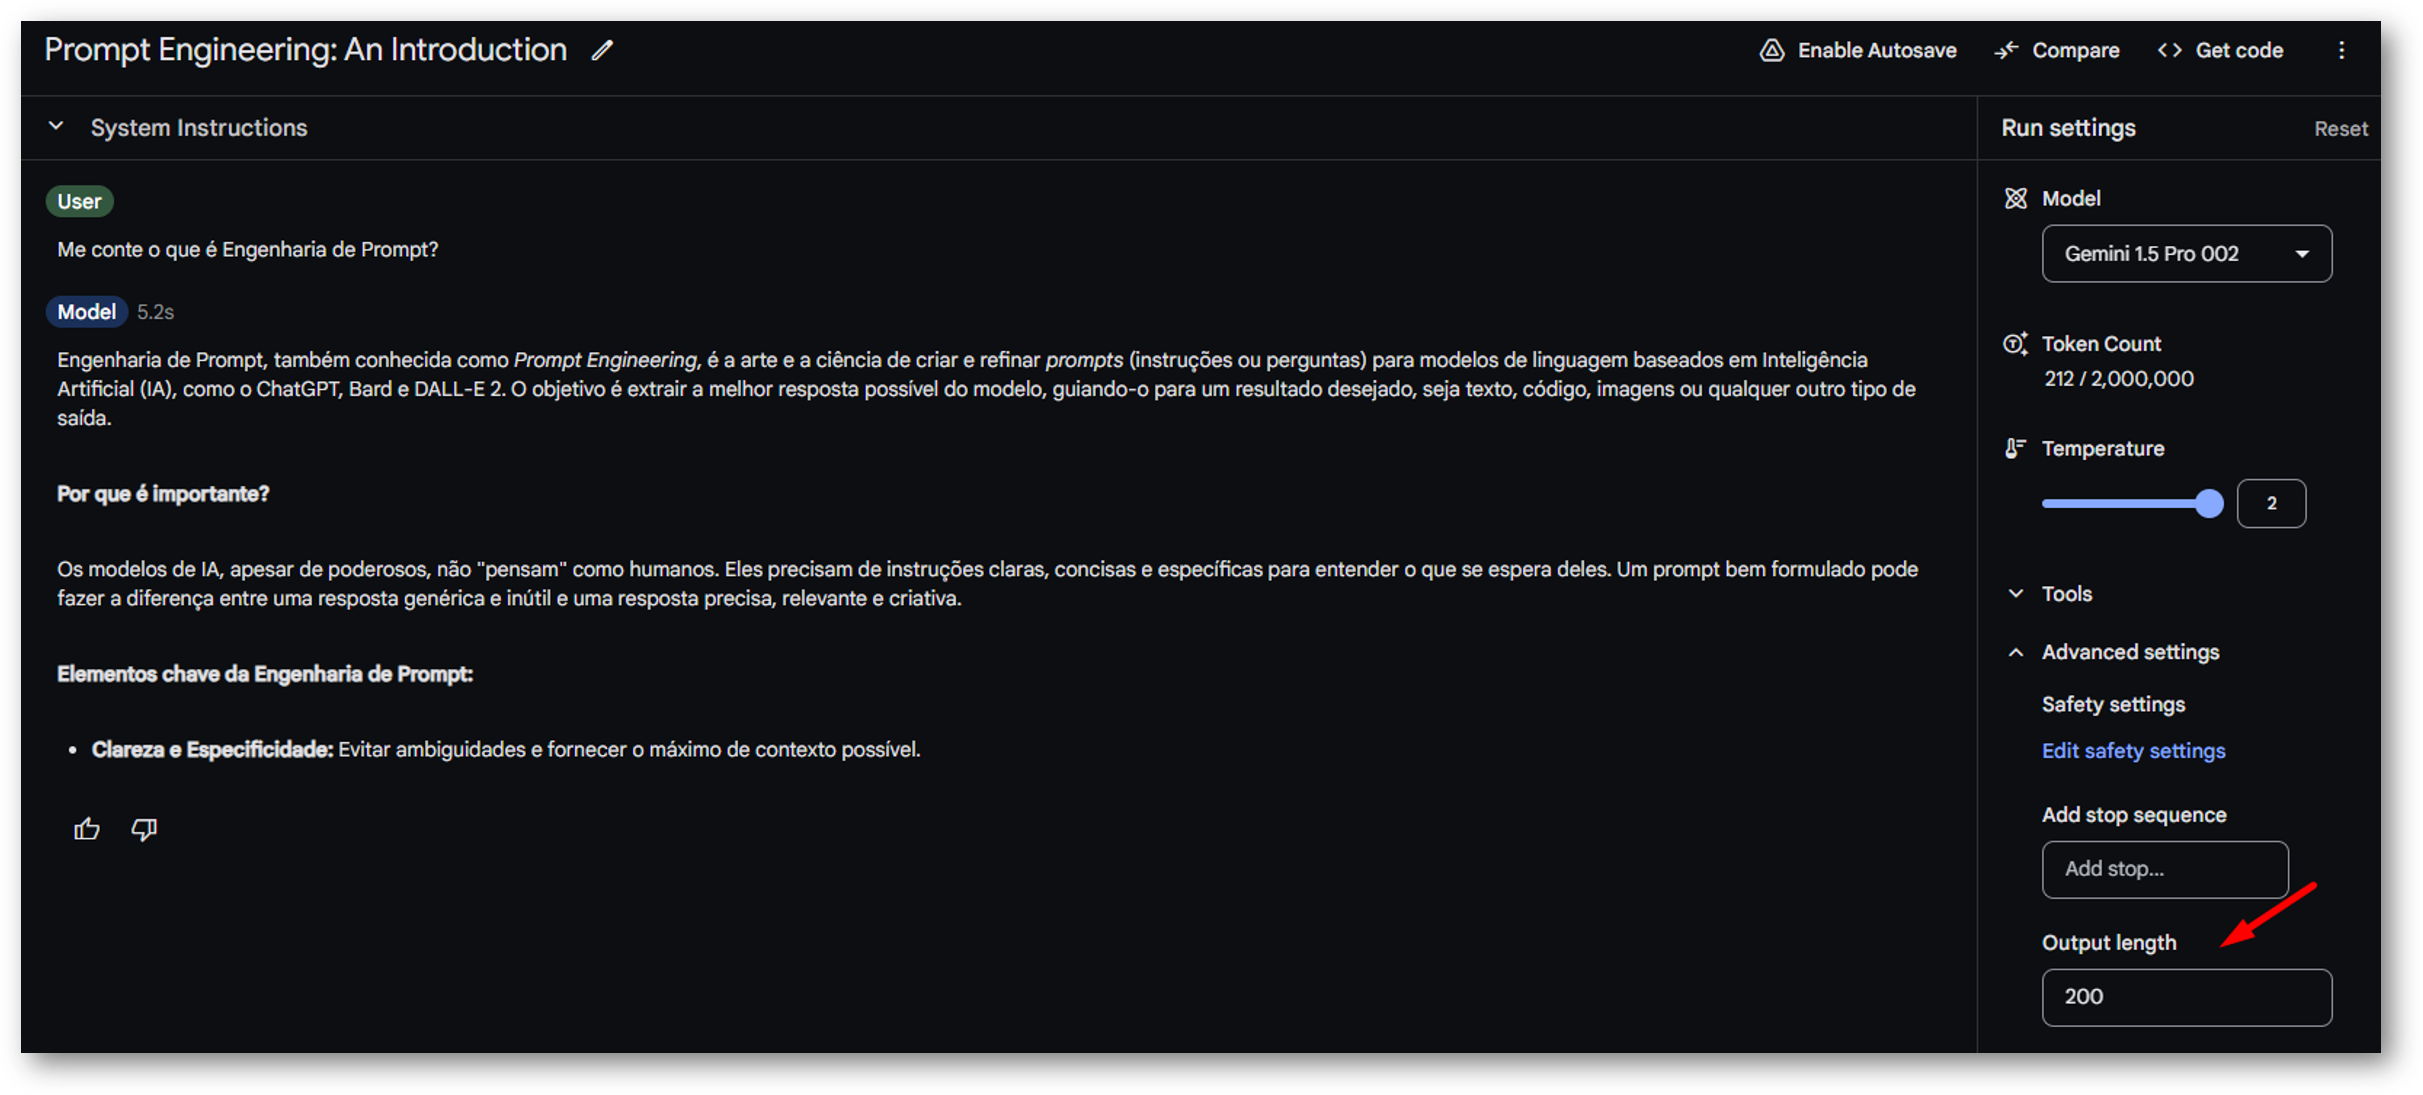
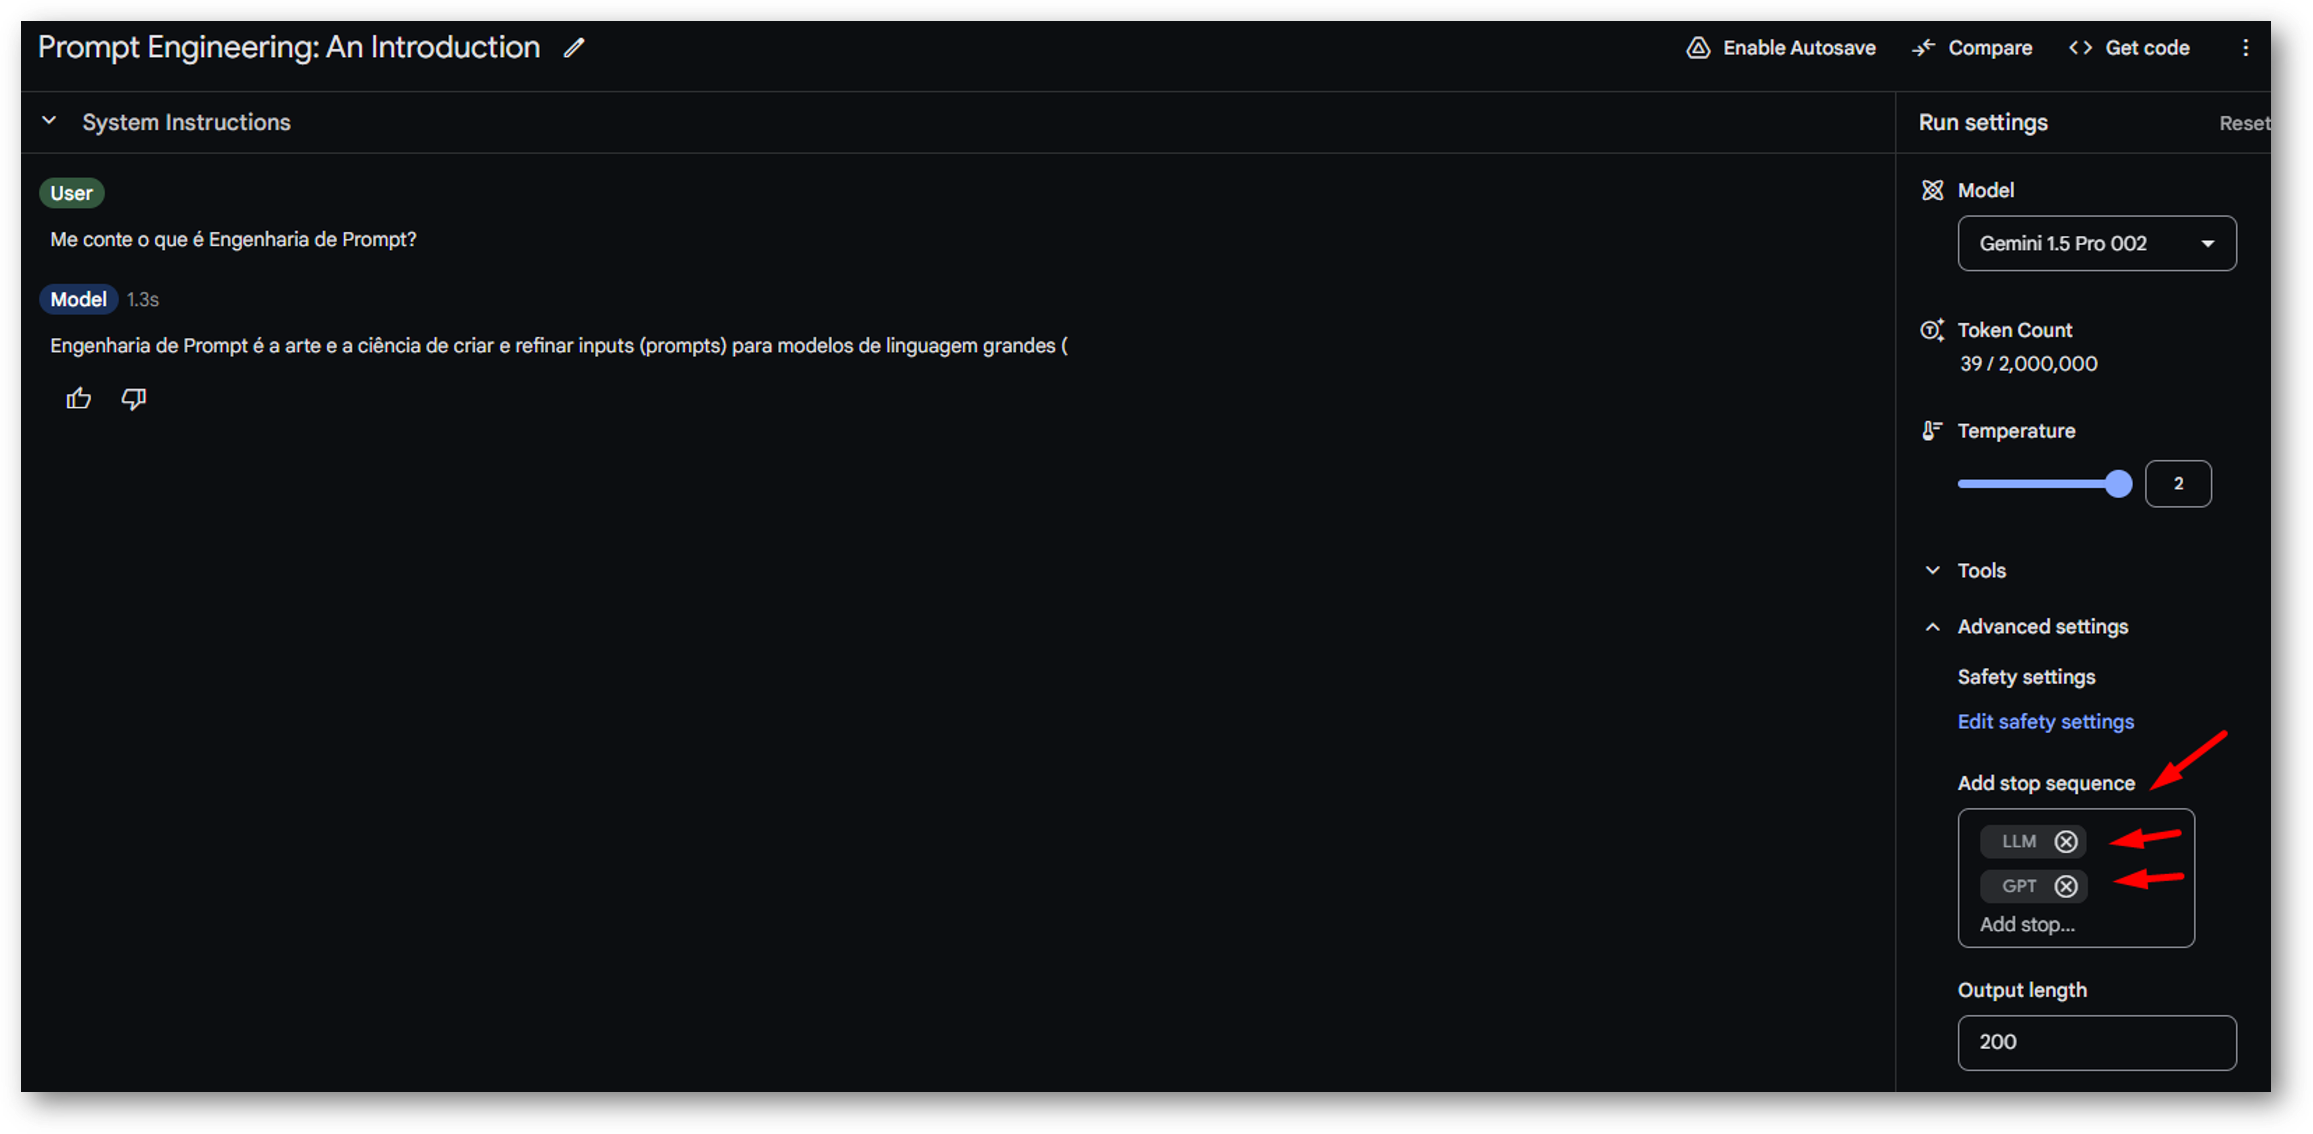
As imagens abaixo foram montadas usando o Google AI Studio.
Para testar na prática, acesse o Google AI Studio ↗, crie um novo chat e altere os parâmetros de geração. A ideia é observar como cada ajuste muda a resposta do modelo usando o mesmo prompt.
System instructions
Define o comportamento base
Serve para orientar papel, tom, regras, limites e formato. É útil para manter consistência em assistentes, páginas de atendimento, análises e fluxos corporativos.
Temperature
Controla o grau de variação
Valores menores tendem a gerar respostas mais previsíveis. Valores maiores podem gerar respostas mais variadas e criativas. Para tarefas analíticas, use menor. Para ideias e brainstorming, experimente maior.
Top-p e Top-k
Limitam o conjunto de tokens considerados
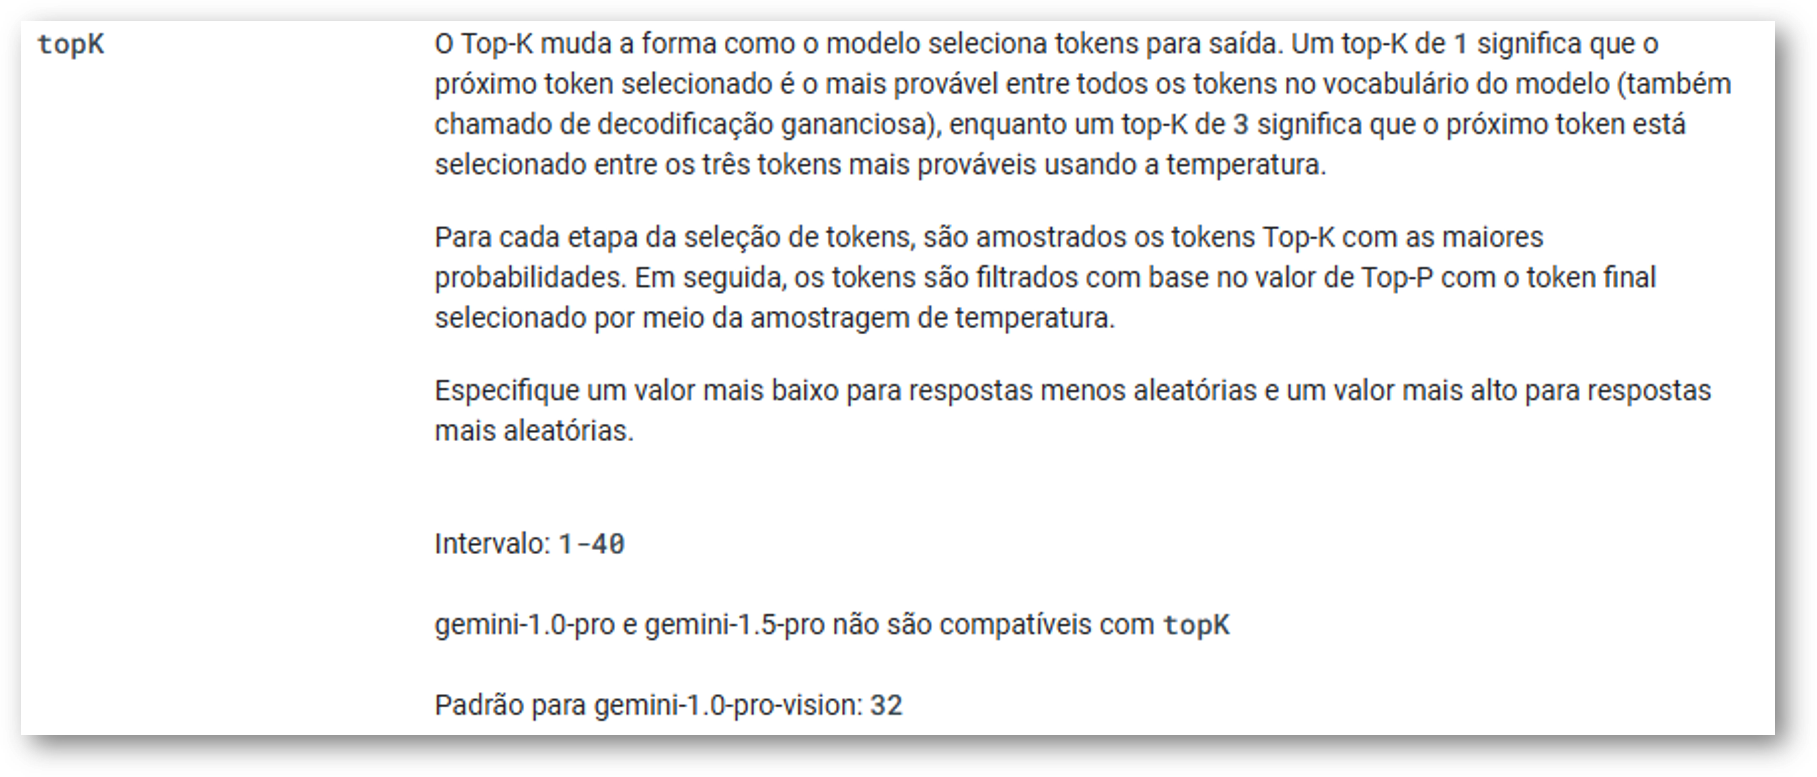
Top-p, também chamado de nucleus sampling, considera tokens até atingir uma massa de probabilidade. Top-k limita a escolha aos k tokens mais prováveis. Em algumas famílias de modelos, nem todos esses parâmetros ficam disponíveis.
Max output tokens
Define o limite de saída
Controla o tamanho máximo da resposta. Ajuda quando você precisa de respostas curtas, saída tabular, resumo executivo ou evitar textos longos demais. Um limite baixo pode cortar respostas antes da conclusão.
Stop sequences
Define onde a geração deve parar
Stop sequences são strings que encerram a geração quando aparecem. São úteis para separar blocos, evitar que o modelo continue depois de uma marca específica ou controlar formatos repetitivos.
Sugestões iniciais
Comece pelo tipo de tarefa.
Use estes valores como ponto de partida conceitual. Ajuste conforme modelo, ferramenta, risco e resultado observado.
| Tarefa | Configuração sugerida | Por quê? |
|---|---|---|
| Resumo executivo | Temperatura baixa, limite claro de tokens, formato definido | Prioriza clareza, concisão e previsibilidade. |
| Consulta SQL ou código | Temperatura baixa, exemplos, critérios de validação | Reduz variação e aumenta consistência técnica. |
| Brainstorming | Temperatura moderada/alta, top-p mais aberto | Permite diversidade de ideias. |
| Atendimento ao cliente | System instructions fortes, RAG, tom definido, limites de segurança | Combina consistência, contexto e controle. |
| Conteúdo de marketing | Temperatura moderada, exemplos de voz, público e CTA | Equilibra criatividade com identidade da marca. |
| Documento jurídico ou financeiro | Temperatura baixa, fontes, revisão humana e rastreabilidade | Reduz risco de criatividade indevida. |
Além dos parâmetros
Quando parâmetro não resolve, entra contexto ou treinamento.
Se a resposta está errada por falta de conhecimento, aumentar ou diminuir temperatura não corrige o problema.
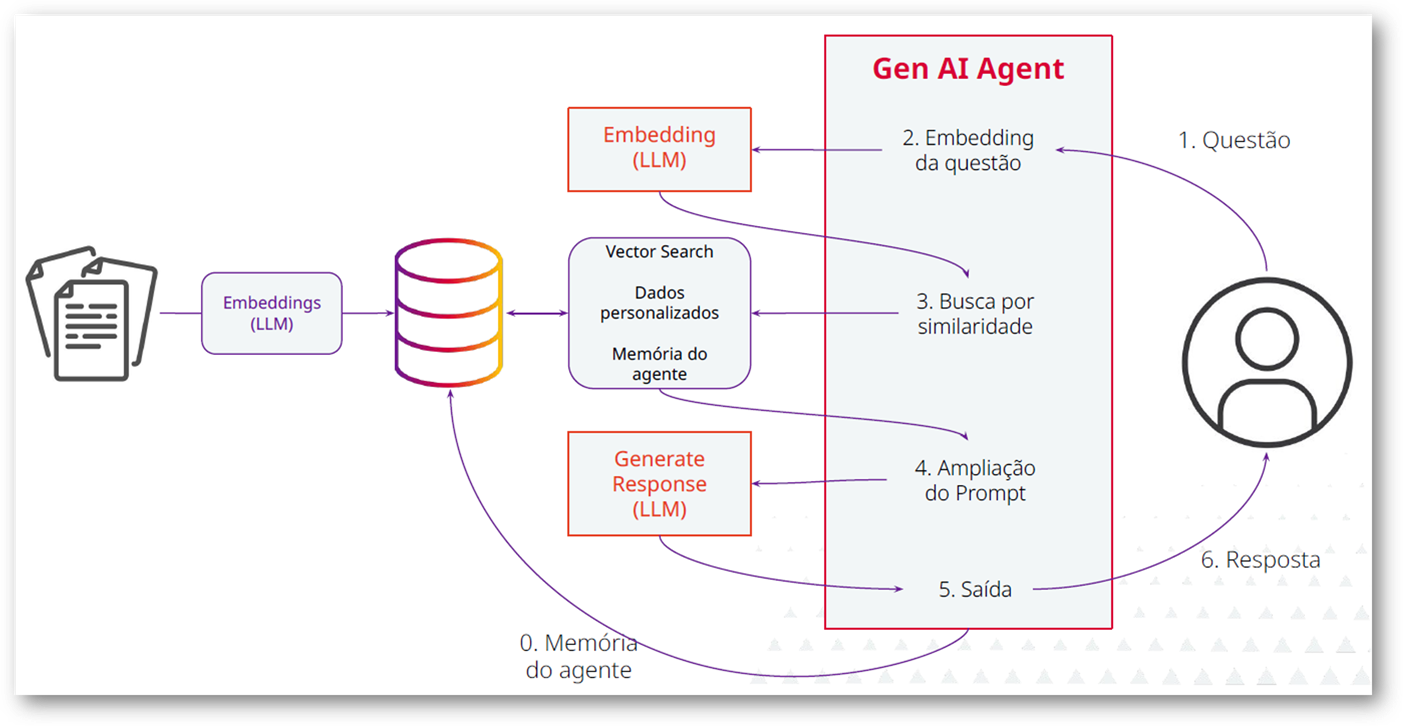
Buscar conhecimento antes de responder
RAG conecta o modelo a documentos, políticas, bases internas ou fontes externas. É indicado quando a resposta precisa usar conhecimento atualizado, específico da empresa ou rastreável.
Ajustar o modelo para padrões recorrentes
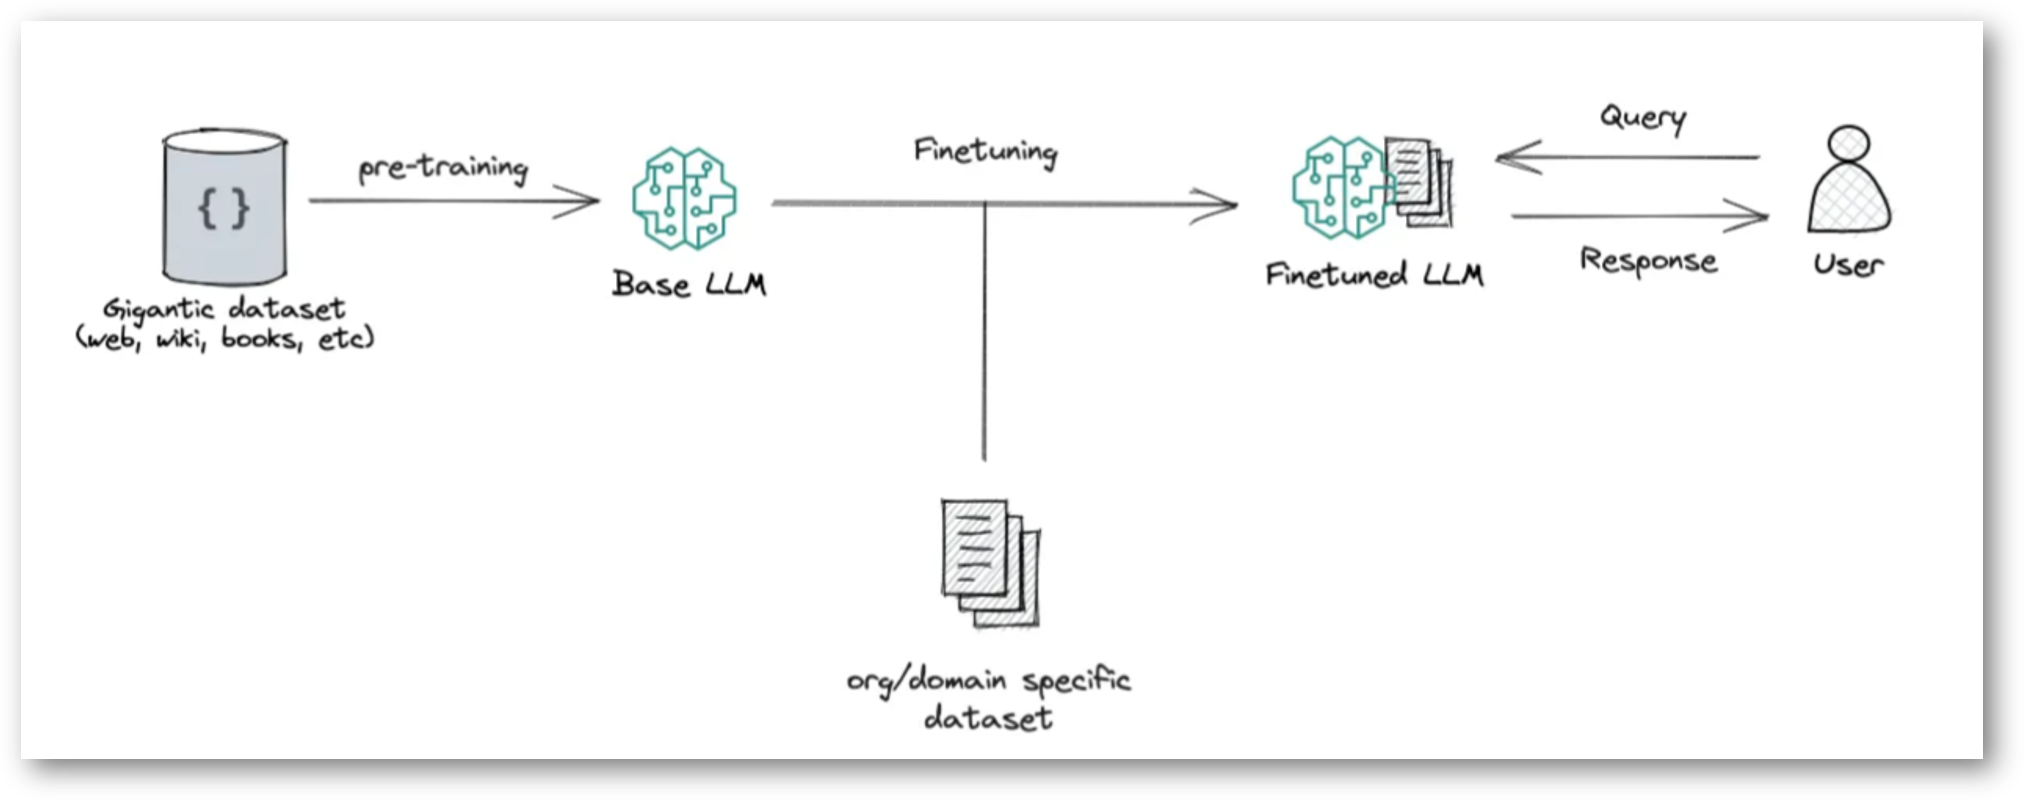
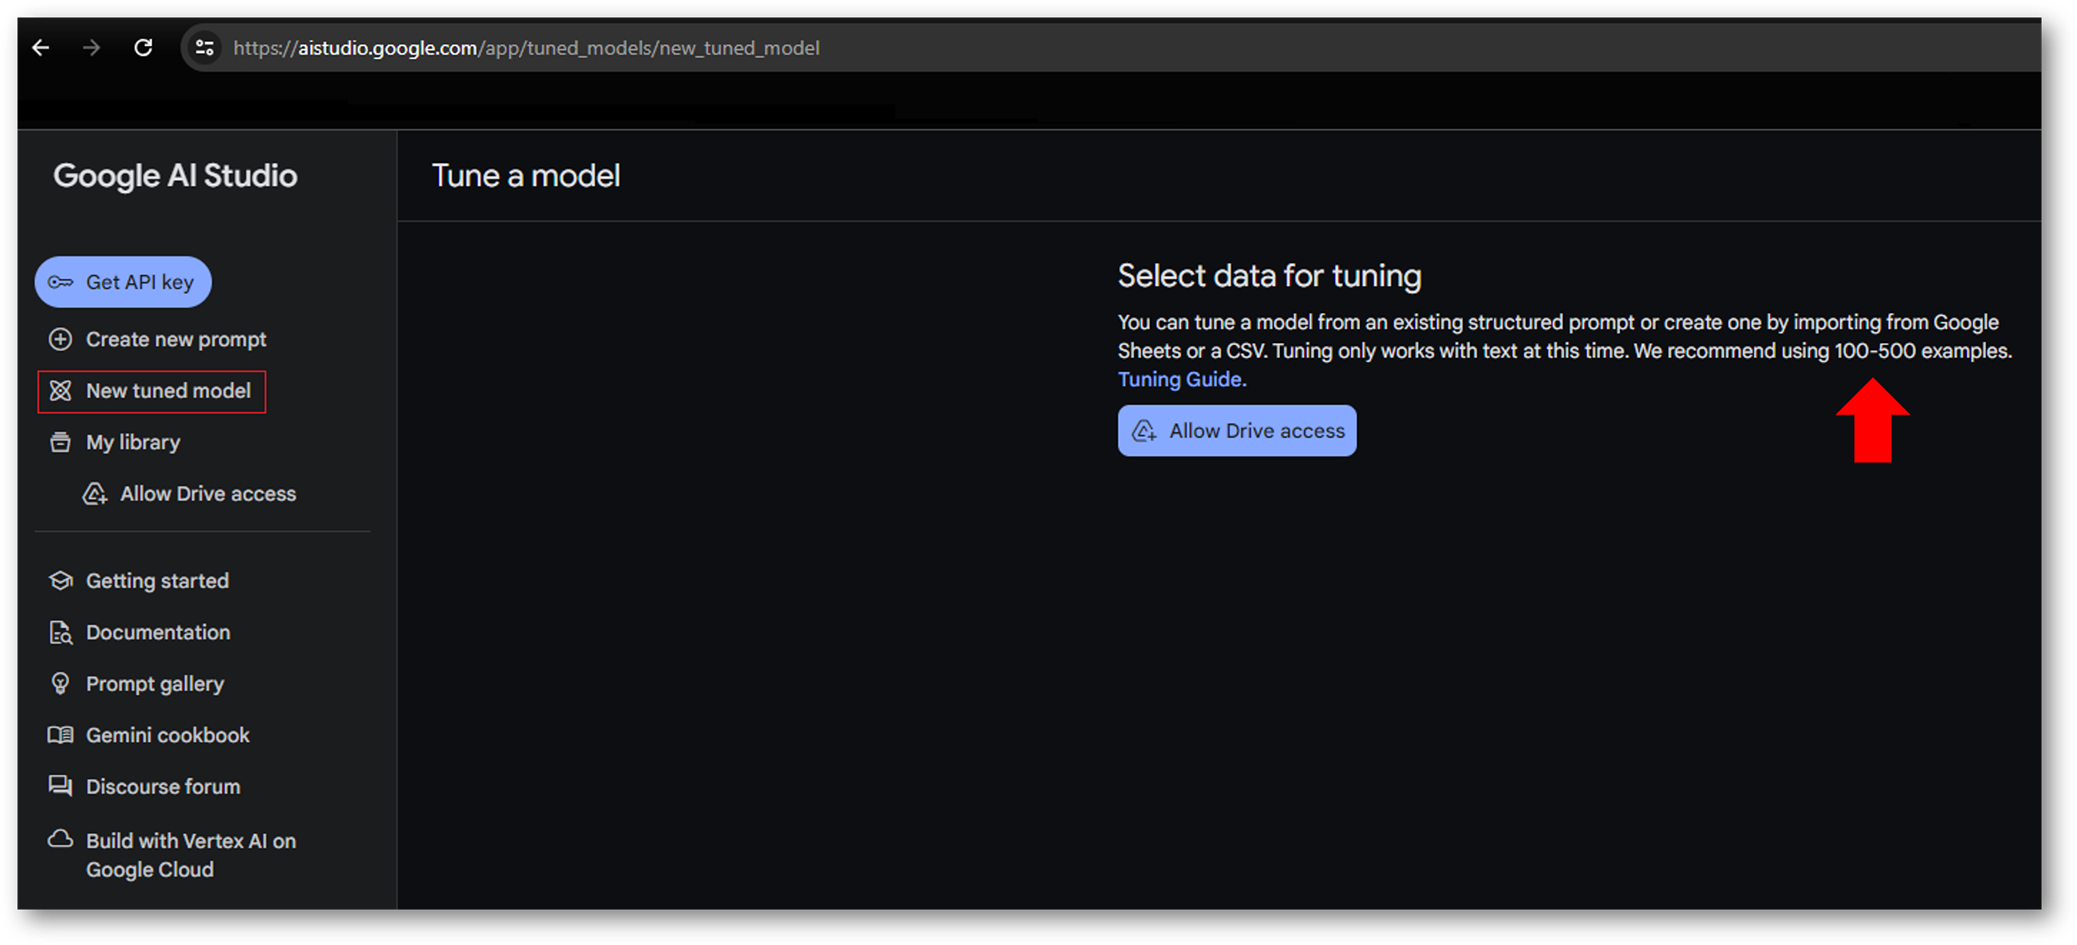
Fine-tuning pode ajudar quando há muitos exemplos de uma tarefa repetida e você precisa reproduzir padrão, estilo, classificação ou comportamento específico. Ele não substitui dados atualizados nem governança.
Roteiro prático
Como calibrar sem virar tentativa e erro.
Teste uma variável por vez e registre o resultado. Calibração sem comparação vira sensação.
Defina o objetivo
Exemplo: responder dúvidas de alunos, gerar SQL, resumir atas, criar posts ou classificar chamados.
Escolha uma saída padrão
Defina formato: tabela, lista, JSON, resumo em cinco bullets, e-mail curto ou passo a passo.
Crie prompts de teste
Separe casos fáceis, médios, difíceis e casos de borda. Use sempre os mesmos testes ao comparar ajustes.
Altere um parâmetro
Mude apenas temperatura, top-p ou limite de tokens. Se mudar tudo, você não saberá o que melhorou.
Avalie por critérios
Meça clareza, precisão, aderência ao formato, uso de fontes, tom, completude e segurança.
Documente o padrão
Registre configuração, modelo, data, exemplos bons, exemplos ruins e quando revisar.
Referências
Para estudar mais.
OpenAIPrompt engineering e boas práticas de instrução.
Google AIConfigurações de geração na API Gemini.
Google CloudParâmetros como temperature, topP, topK e limites.
ArtigoComo a temperature influencia respostas.
ArtigoComo o top-p influencia respostas.
ArtigoComo o top-k influencia respostas.
ArtigoRAG — Retrieval-Augmented Generation.
Veja tambémEngenharia de Contexto para IA.