Regressão
Prevê um número: demanda, preço, tempo, consumo ou risco contínuo.
- Linear, Ridge, Lasso e Elastic Net
- Árvores, Random Forest e Gradient Boosting
- SVR e KNN Regressor
Trilha de estudo · modelos preditivos
Machine Learning (ML), ou Aprendizado de Máquina, é um ramo da Inteligência Artificial (IA) que permite que computadores aprendam e tomem decisões com base em dados, sem a necessidade de serem explicitamente programados para cada tarefa. Em vez disso, os sistemas são treinados com dados e algoritmos para identificar padrões e melhorar seu desempenho ao longo do tempo.
01 · Fundamentos
O conjunto de treino ajusta parâmetros; validação orienta escolhas; teste estima desempenho final. Misturar esses papéis produz uma avaliação otimista.
Prevê um número: demanda, preço, tempo, consumo ou risco contínuo.
Prevê classes ou probabilidades: fraude, churn, aprovação, espécie ou diagnóstico.
Agrupa observações semelhantes sem uma resposta conhecida.
Resume variáveis, remove ruído e ajuda a visualizar estruturas.
Combinam poucos rótulos, muitos dados brutos e objetivos auxiliares para aprender representações.
O agente aprende ações por recompensas. Estado, política, exploração e retorno substituem o rótulo tradicional.
02 · Algoritmos clássicos
Comece com uma linha de base simples. Compare desempenho, custo, estabilidade, latência, explicabilidade e manutenção.
| Família | Intuição | Pontos fortes | Cuidados | Estudar |
|---|---|---|---|---|
| Linear / logística | Combina variáveis por pesos. | Rápida, interpretável, boa baseline. | Relações não lineares e colinearidade. | Documentação ↗ |
| KNN | Usa vizinhos próximos. | Simples, não paramétrico. | Escala, dimensão e custo de inferência. | Documentação ↗ |
| Árvore de decisão | Cria regras por divisões. | Explicável, aceita relações não lineares. | Instabilidade e overfitting. | Documentação ↗ |
| Random Forest | Combina muitas árvores diversas. | Robusta e forte em dados tabulares. | Modelo maior e explicação agregada. | Documentação ↗ |
| Gradient Boosting | Árvores corrigem erros anteriores. | Alta qualidade em tabelas. | Hiperparâmetros, leakage e calibração. | Documentação ↗ |
| SVM | Maximiza margem entre classes. | Funciona bem em espaços complexos. | Escala e escolha de kernel. | Documentação ↗ |
| Naive Bayes | Aplica Bayes com independência condicional. | Rápido, forte baseline para texto. | Hipótese de independência simplifica demais. | Documentação ↗ |
| K-means | Aproxima pontos de centróides. | Eficiente e fácil de explicar. | Exige k; sensível à escala e outliers. | Documentação ↗ |
| DBSCAN | Forma regiões densas. | Descobre formas irregulares e ruído. | Parâmetros variam com densidade. | Documentação ↗ |
03 · Algoritmos e bibliotecas
Os links apontam para documentação oficial. Use o scikit-learn como base para aprender a API de estimadores e avance para bibliotecas especializadas quando o problema justificar.
Para prever números, classes ou probabilidades a partir de exemplos rotulados.
Modelos não lineares fortes para tabelas, com diferentes trocas entre qualidade e custo.
Para agrupar, reduzir dimensões e explorar relações sem uma resposta conhecida.
Bibliotecas que apoiam o trabalho antes, durante e depois do treinamento.
04 · Métricas
Acurácia não basta quando classes são raras. R² não mostra sozinho o tamanho do erro. Cluster “bonito” pode não ter significado de negócio.
MAE mantém a unidade e é robusta. RMSE pune erros grandes. R² compara variância explicada. MAPE exige cuidado com zeros e valores pequenos.
Precision: entre alertas, quantos corretos? Recall: entre positivos reais, quantos encontrados? F1 combina ambos. ROC-AUC e PR-AUC avaliam ranking.
Avaliam probabilidades, não apenas a classe final. Curvas de calibração mostram se 70% significa aproximadamente sete acertos em dez.
Silhouette mede coesão e separação; Davies-Bouldin penaliza sobreposição; Calinski-Harabasz compara dispersões. Validação de negócio continua necessária.
Altere os valores e observe por que métricas diferentes contam histórias diferentes sobre o mesmo modelo.
05 · Validação
O teste precisa representar o futuro uso do modelo. Tempo, grupos, duplicidades e pré-processamento mudam a estratégia de separação.
Ocorre quando o treino recebe informação indisponível na previsão real: futuro, resposta disfarçada, estatística calculada com todo o conjunto ou duplicatas entre partições.
Dados, relações ou prevalência mudam depois do deploy. Monitore entrada, desempenho, calibração e resultado de negócio.
06 · Projetos guiados
Escolha um projeto. Cada exemplo parte de uma pergunta, usa dados acessíveis, indica a métrica adequada e entrega um código-base para continuar experimentando.
Use características de distritos da Califórnia para estimar o valor mediano das residências.
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

X, y = fetch_california_housing(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = make_pipeline(StandardScaler(), Ridge(alpha=1.0))
model.fit(X_train, y_train)
pred = model.predict(X_test)

print("MAE:", mean_absolute_error(y_test, pred))
print("RMSE:", mean_squared_error(y_test, pred) ** 0.5)
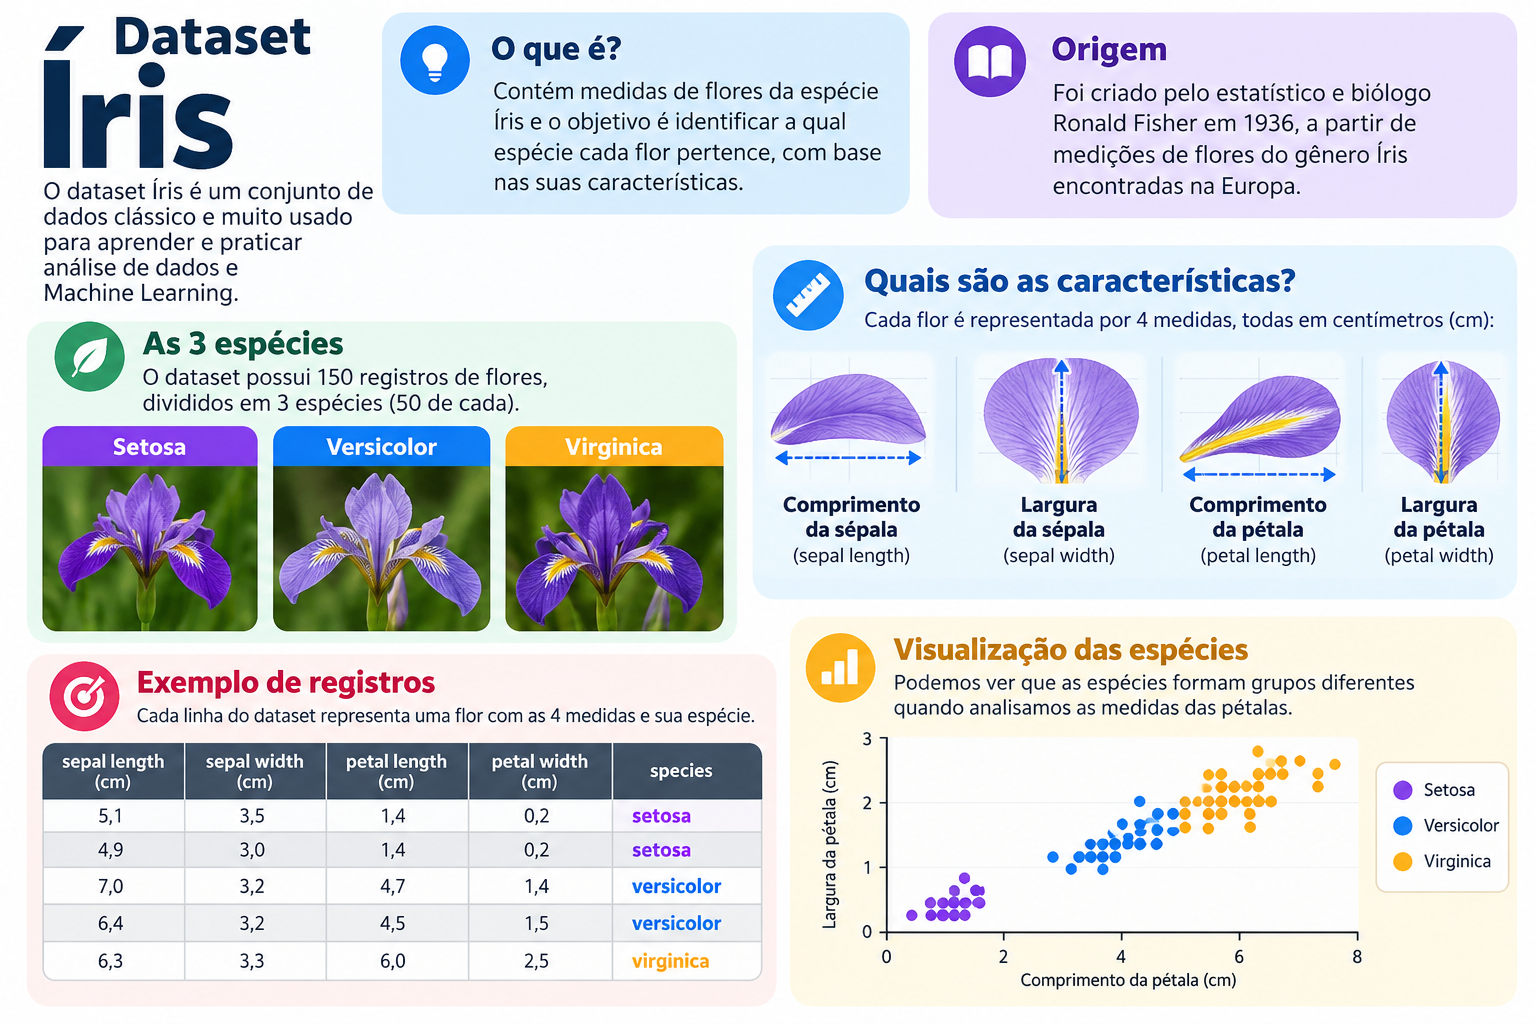
print("R²:", r2_score(y_test, pred))Use quatro medidas de uma flor para prever uma entre três espécies.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

model = make_pipeline(
    StandardScaler(),
    LogisticRegression(max_iter=1000)
)
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(confusion_matrix(y_test, pred))
print(classification_report(y_test, pred))Agrupe as flores pelas medidas e investigue se a estrutura encontrada faz sentido.
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

X, _ = load_iris(return_X_y=True)
X_scaled = StandardScaler().fit_transform(X)

for k in range(2, 7):
    model = KMeans(n_clusters=k, n_init=10, random_state=42)
    labels = model.fit_predict(X_scaled)
    score = silhouette_score(X_scaled, labels)
    print(f"k={k} · silhouette={score:.3f}")

# Depois, descreva cada grupo pelas médias das variáveis.Classifique casos como malignos ou benignos, tratando recall como uma decisão de contexto.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import classification_report

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

model = make_pipeline(
    StandardScaler(),
    SVC(kernel="rbf", C=1.0, class_weight="balanced")
)
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(classification_report(y_test, pred))Combine árvores que corrigem os erros anteriores e compare o resultado com uma baseline simples.
# pip install xgboost
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
from xgboost import XGBClassifier

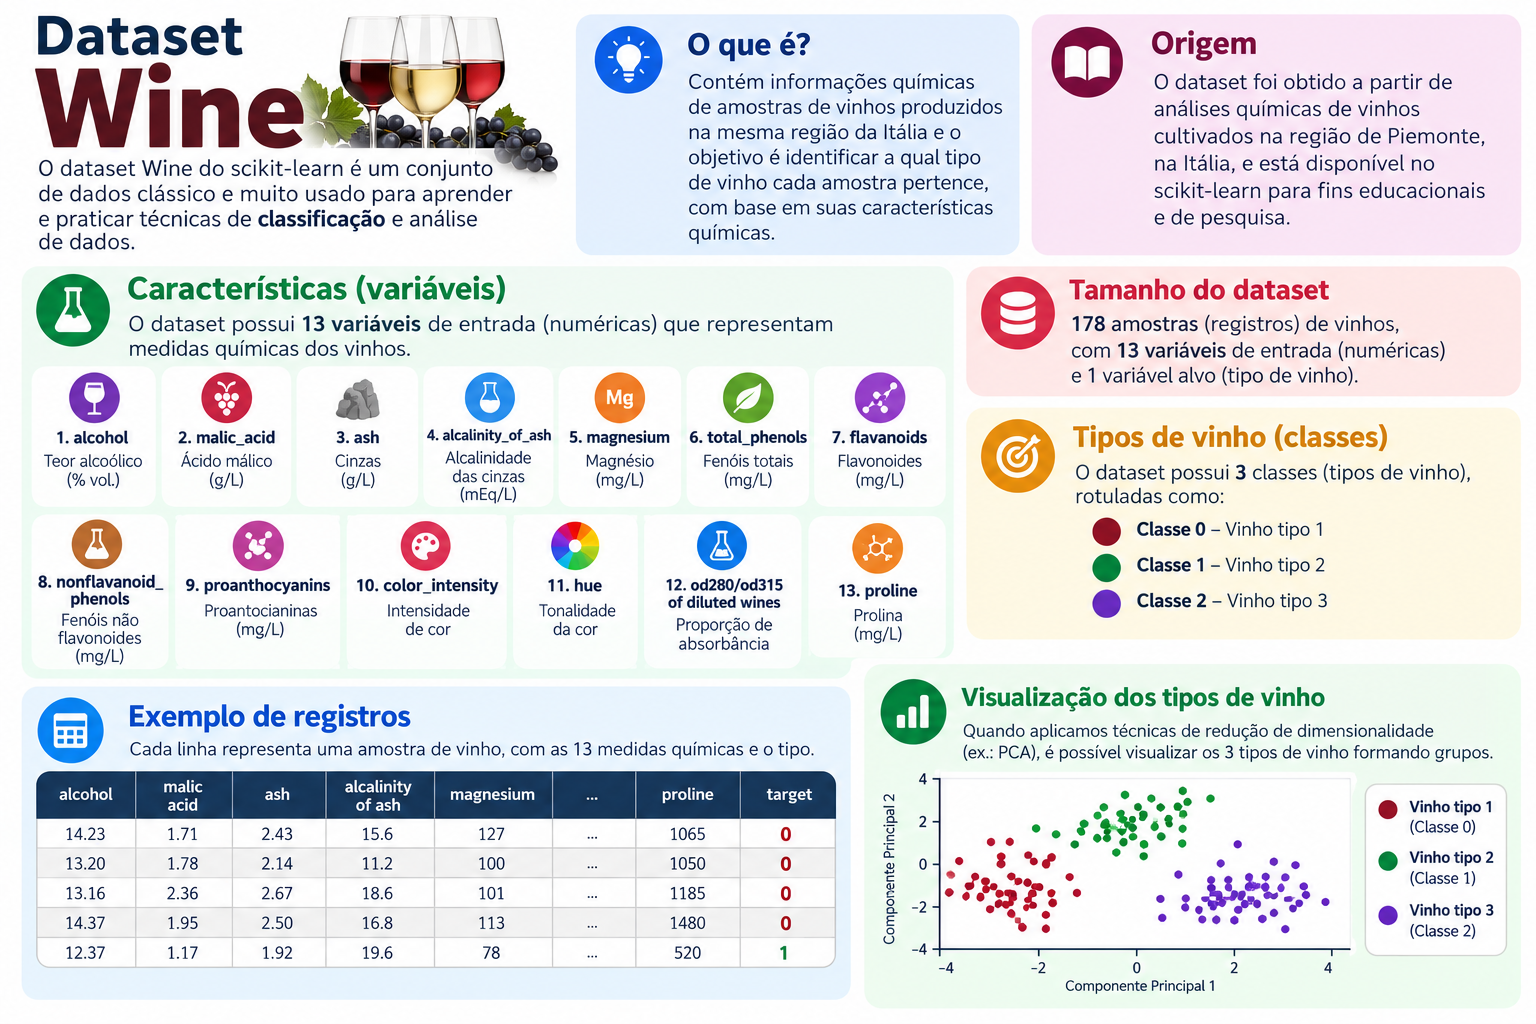
X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

model = XGBClassifier(
    n_estimators=300, max_depth=4,
    learning_rate=0.05, subsample=0.8,
    colsample_bytree=0.8, eval_metric="mlogloss",
    random_state=42
)
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(classification_report(y_test, pred))
Regra comum aos cinco: a escolha do algoritmo vem depois da pergunta, da métrica e da estratégia de validação.
07 · Downloads
Baixe cada exercício em Jupyter Notebook (.ipynb) e abra no Jupyter ou no Google Colab. As bases são carregadas pelo scikit-learn; os CSVs são opcionais e acompanham o pacote completo.
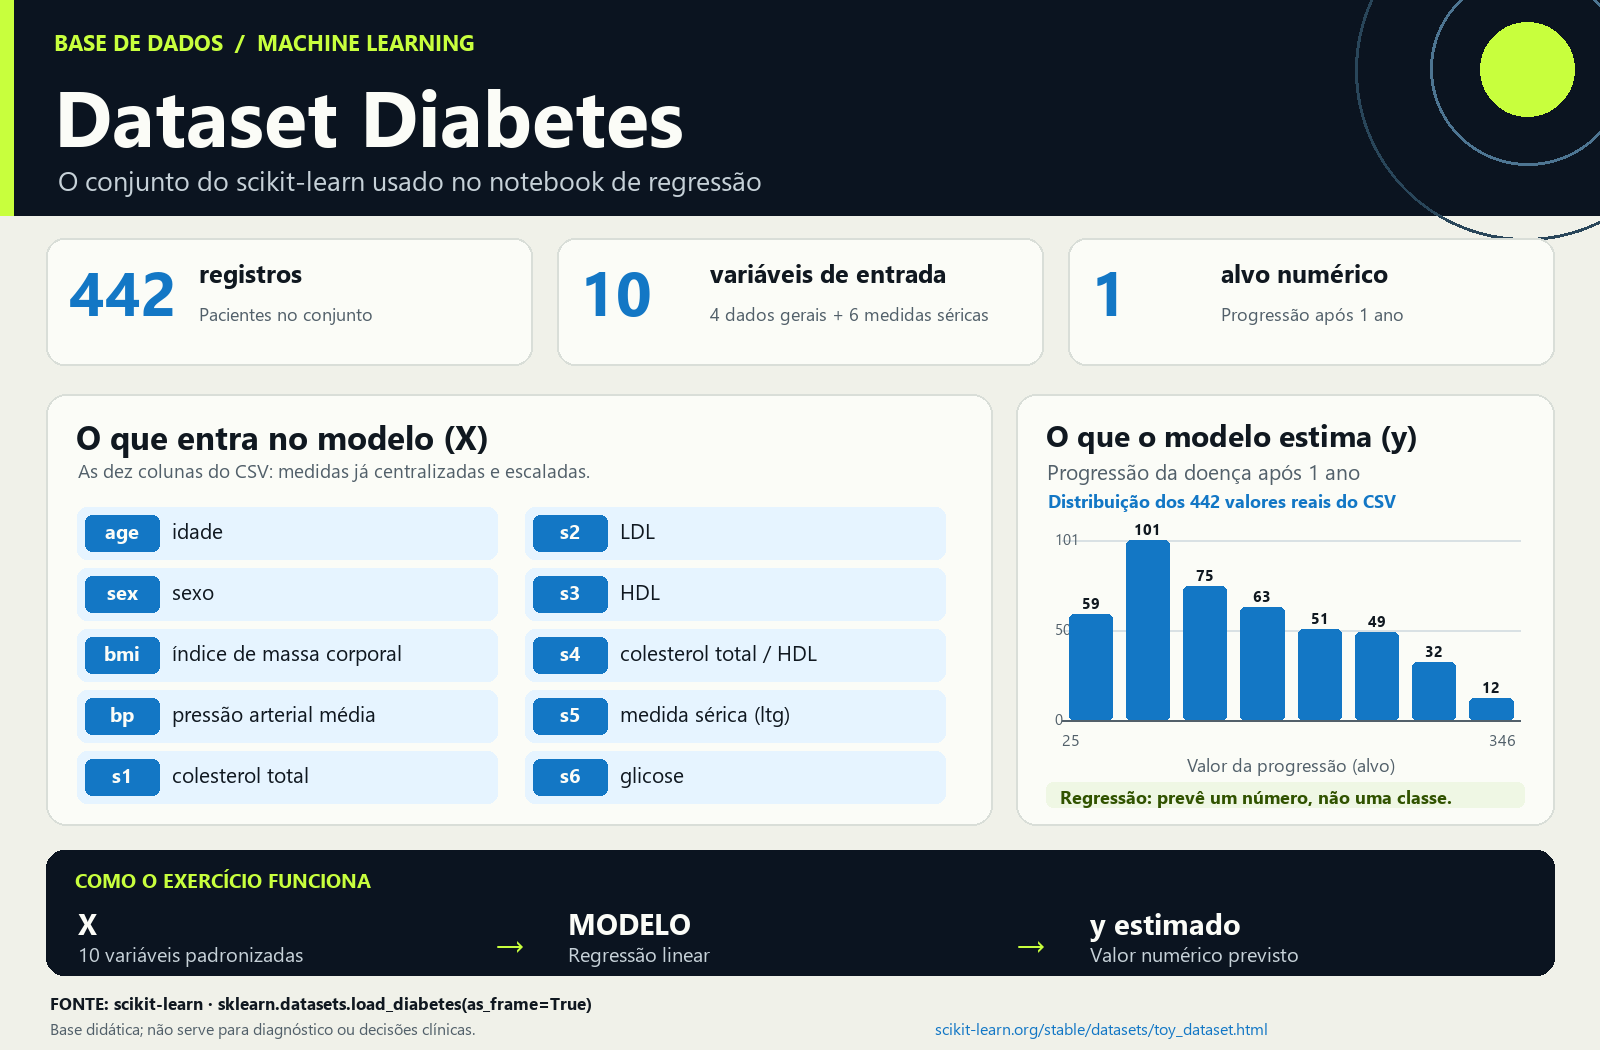
Os notebooks são independentes dos projetos rápidos acima. O exercício com Diabetes é didático e não se destina a decisões clínicas.
08 · Leituras
Use o artigo como projeto de entrada e a documentação para aprofundar validação, métricas e algoritmos.